W&B:优化过程与系统诊断
本次通过 scan_history() 读取四个已完成 W&B run 的完整、未抽样 history。每个 run 有 100 个日志事件,其中包含 20 个 rollout batch、40 次优化器更新;合并后为 80 rollout steps、160 次优化器更新。与本地提取重叠的 3,118 个数值全部完全一致。
| Round | Run | State | History events |
|---|---|---|---|
| R0 | 8ov14yyc | finished | 100 |
| R1 | chjizc8u | finished | 100 |
| R2 | 7vhbv5j0 | finished | 100 |
| R3 | y4xk6byf | finished | 100 |
横轴必须分清
W&B _step 是日志事件计数,不是训练迭代数。本次显式 rollout/step 为 1–80,train/step 为 2–161。图中优化器更新序号取 train/step − 1,对应 rollout step 为 floor(train/step / 2),并按各 run 轮次和覆盖范围验证。缺失指标不做插值补齐。
策略诊断
| Round | Entropy | Clip fraction | Gradient norm | Actor tokens/s |
|---|---|---|---|---|
| R0 | 0.18025 | 0.00123 | 2.18 | 13538.13 |
| R1 | 0.15557 | 0.00058 | 2.16 | 13502.78 |
| R2 | 0.14212 | 0.00056 | 1.38 | 13468.47 |
| R3 | 0.13258 | 0.00038 | 1.14 | 13527.11 |
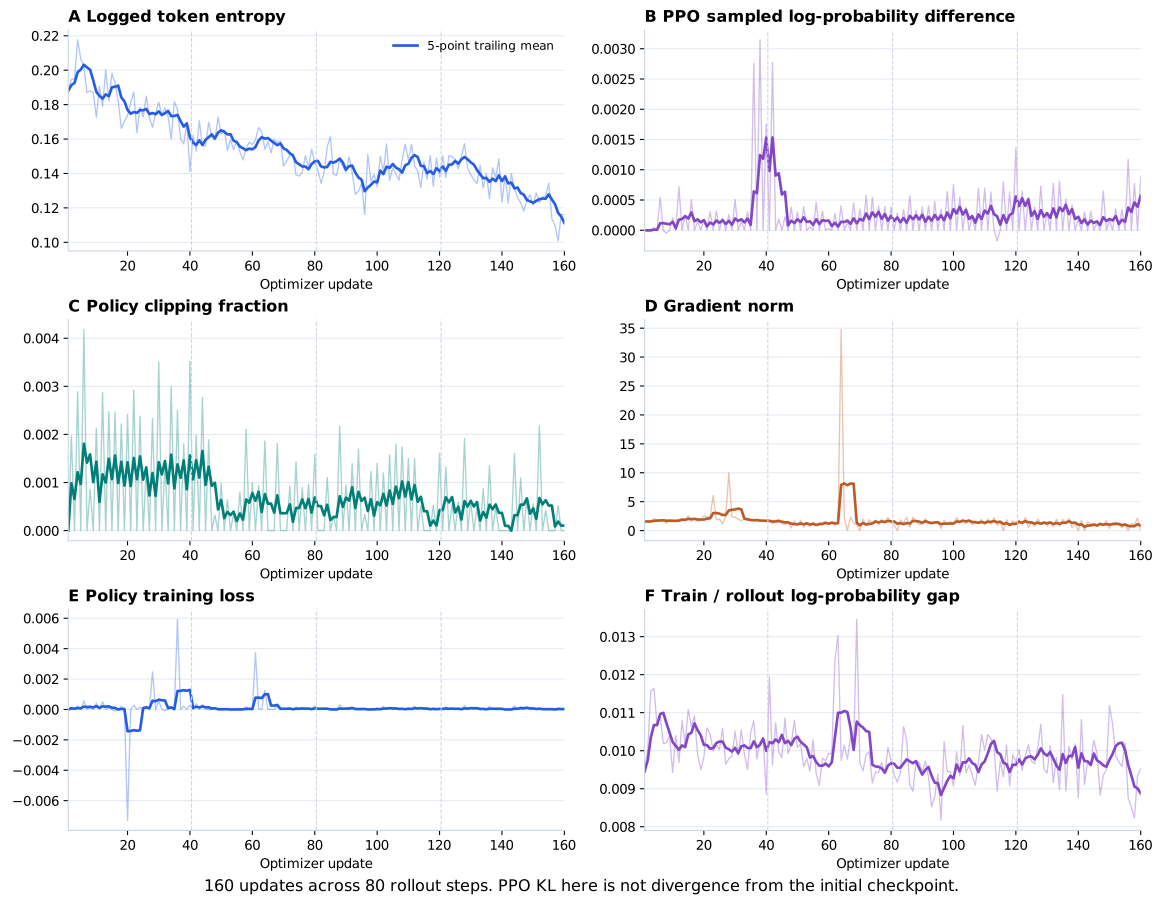
日志熵均值从 0.1802 降到 0.1326,约下降 26%。本地 slime loss 实现中的 entropy_loss 是按训练样本归约后的熵统计,不是完整目标函数。熵降低说明这些训练数据上的 token 分布更集中,不能单独证明校准更好、任务能力更广或语义多样性减少。
PPO loss 路径中的 train/ppo_kl 是采样 token 上 old-minus-current log probability 差值,不能当作相对初始模型的 KL。一个 rollout batch 的第一次更新中 old/current policy 相同,接近零是预期现象;第二次更新发生在权重已变化之后。应结合每 batch 两次更新的结构看整条曲线和 clipping fraction。
轮均 clipping fraction 从 0.00123 降至 0.00038,平均 gradient norm 从 2.18 降至 1.14。共有八次记录的零梯度更新,展示序号为 66、70、82、116、140、142、156、160。这些是可观测诊断,不足以认定训练 bug 或完全收敛;确定原因需要实际接纳 minibatch 的 advantages 和 optimizer state。
Train/rollout log probability 绝对差均值保持在约 0.01,它诊断生成侧与训练侧数值计算的一致性,与 reward 是不同问题。Group-relative reward normalization 下,接近零的 loss 也不是任务质量的直接衡量。
响应长度与性能
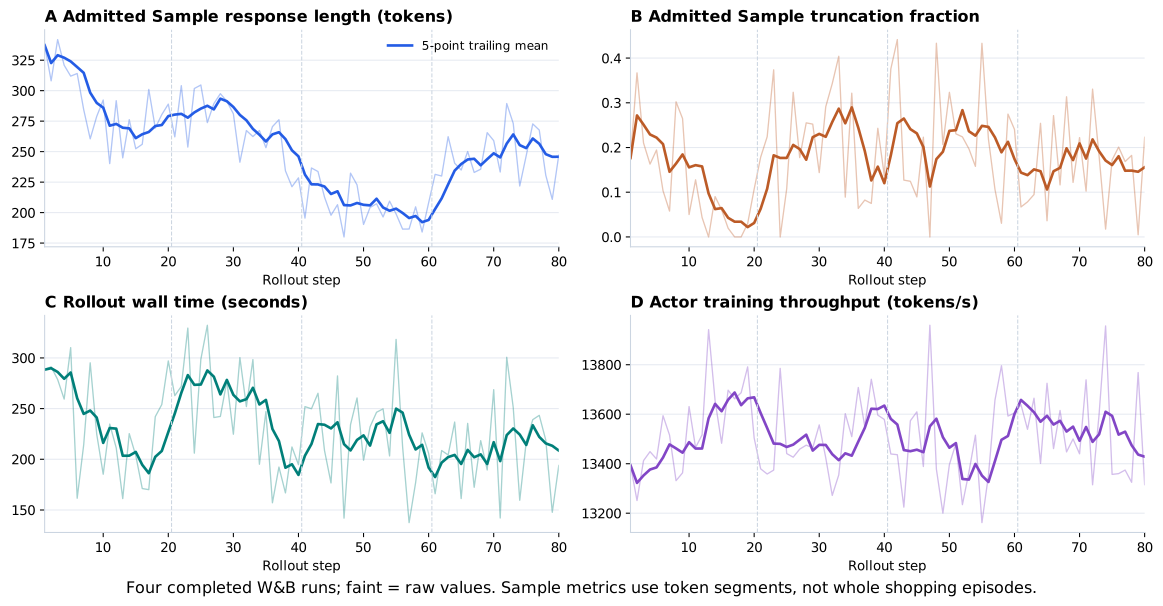
W&B 的 rollout/response_len/mean 对已接纳 slime Samples 的有效响应长度求均值。动态工具 schema 可让一个 episode 分段,所以它不是一次购物 episode 的总生成均值。rollout/truncated_ratio 同样是 Sample status 比例。行为分析则直接计算模型 turn 和完整 episode。
各轮已接纳 Sample 的平均响应长度约为 288、269、205、247 token,形状与事后生成曲线相近,但统计群体和权重不同。Sample 截断比例为 11.8%、20.4%、22.3%、15.8%,不能称为 episode 失败率。
四轮 actor training throughput 均值均约 13.5k tokens/s;每 batch rollout wall time 均值分别约 234、245、224、209 秒。这些数字受当前机器、并发、上下文分布和服务调度影响。某条计时序列之和不包含项目所有验证、技能分析、启动和等待时间。
可复算来源
下载 rollout CSV、optimizer CSV、汇总 JSON 和来源 manifest。各 run 的冻结 JSON 仅保留数值 history,不导出凭据、run config、console log 或 media。
下载脚本使用 W&B public API 的完整 history 迭代器,聚合与绘图可离线运行。指标语义已对照本地 slime 的 loss.py、model.py 与 rollout metrics 实现;它们是框架诊断,不是新的购物 reward 定义。