模型在训练中怎样改变购物行为
仅看奖励,无法区分生成更短、工具使用更好、搜索更执着,还是被解决任务的构成变化。本次提取 20,480 条训练 episode / 110,997 个模型 turn,以及九个条件的 3,600 条完成评测轨迹。这是事后分析,没有新增模型采样。
指标定义
| 指标 | 定义 |
|---|---|
| 模型步数 | 保存的模型生成次数,包含未成功执行动作的协议修复 |
| 动作 / 有效动作 | 提交的 action / 环境反馈明确接受的 action |
| 每步 token | 先对完整 episode 计算总生成 token / 模型步数,再对 episode 平均 |
| Pooled 每步 token | 总 token / 总 turn,长 episode 权重更大 |
| 训练 token | 对保存的 raw_output 重编码,包含 reasoning 与工具调用标记,不是原始采样 ID |
| 评测 token | API 记录的 completion_tokens,含 reasoning,不含输入 token |
| 搜索 / 不同查询 | 有效执行的搜索 / 规范空白、忽略大小写后的不同查询 |
| 打开商品 | 从搜索结果到商品详情的有效状态转移 |
| 不同商品 / 重访 | 打开过的不同商品 ID / 再次打开同一个 ID |
| 选规格 / 改规格 | 有效规格点击 / 把已选择的规格轴改为另一值 |
| 回退 / 翻页 | 从详情返回或重启搜索 / 在搜索结果页之间导航 |
| 协议错误 / 无效动作 | 模型输出解析失败 / 环境明确返回动作无效 |
选择颜色、尺码时刷新的是同一商品页,不增加打开商品数。仅在搜索结果中出现的商品不计为浏览过的商品详情。全部可评分训练 episode 和完成评测 episode 都有完整 token 计数;技术故障单独标记。本次不重建 failed attempts 的全部请求成本。
成功路径保持短,剩余失败具有更长尾部
| 轮次 | 结果 | n | 模型步 | token/步 | 搜索 | 不同商品 |
|---|---|---|---|---|---|---|
| R0 | 成功 | 3234 | 4.54 | 259.01 | 1.07 | 1.05 |
| R0 | 失败 | 1827 | 6.76 | 309.66 | 1.41 | 1.25 |
| R1 | 成功 | 4191 | 4.58 | 250.32 | 1.07 | 1.05 |
| R1 | 失败 | 929 | 9.72 | 276.21 | 2.03 | 1.41 |
| R2 | 成功 | 4281 | 4.83 | 184.66 | 1.13 | 1.04 |
| R2 | 失败 | 839 | 10.28 | 217.82 | 2.28 | 1.44 |
| R3 | 成功 | 4471 | 4.56 | 209.91 | 1.07 | 1.04 |
| R3 | 失败 | 649 | 8.97 | 299.44 | 2.07 | 1.30 |
成功训练轨迹的均值保持在约 4.5–4.8 步,每轮中位数都是四步。失败均值由 R0 的 6.76 升至 R3 的 8.97,R2 达到 10.28;失败步数 p90 分别为 13、22、22、18.2。随着失败群体缩小,剩余任务更具有选择性。这描述剩余失败分布,不能证明训练把同一个失败任务变得更难。
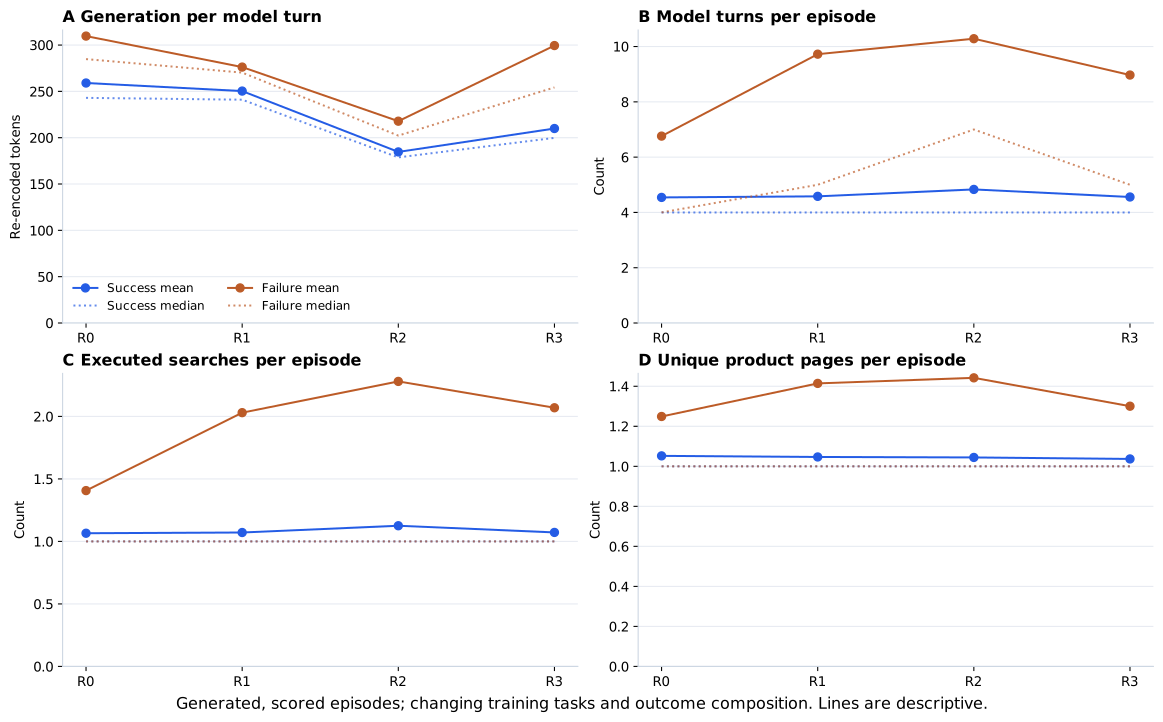
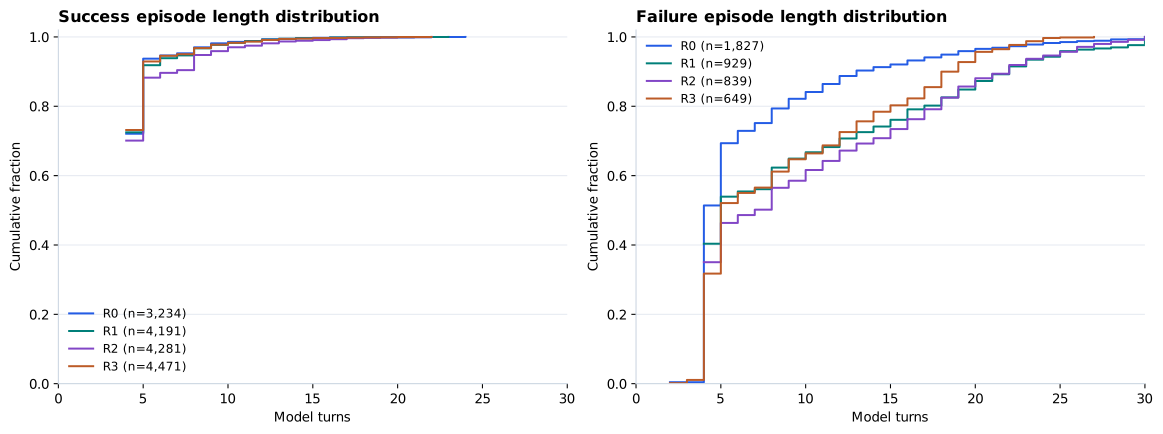
R0 有 59 条技术上不可评分的轨迹,它们不进入成功/失败均值,也不被记为 reward=0 的策略失败。R0 与 R3 生成任务 ID 没有交集,无法估计训练轮次间的同任务差值;下面使用固定验证集做纵向比较。
生成缩短的证据比交互减少更清楚
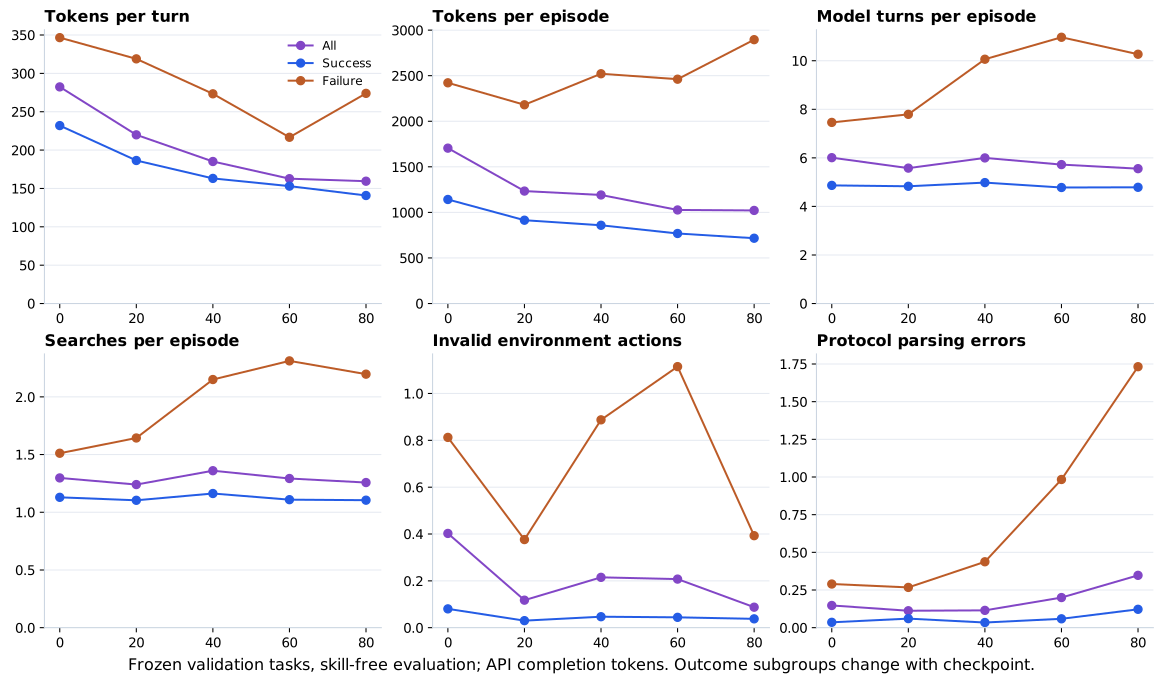
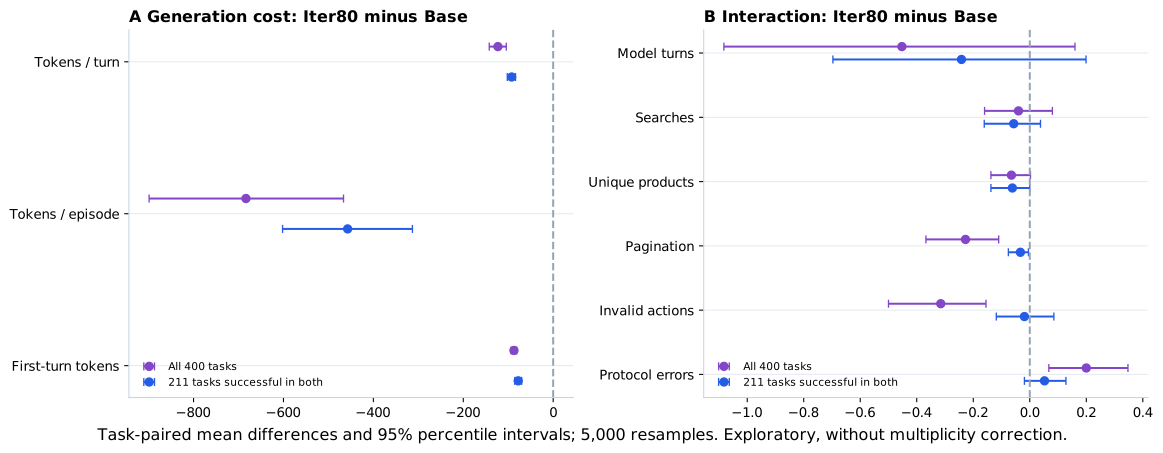
同一组 400 个 bare-validation 任务上,Base → Iter80 的平均每步 token 从 282.39 降至 159.46(−43.5%),每 episode token 从 1,704.93 降至 1,021.50(−40.1%)。首次生成由 216.61 降至 129.37 token,此时尚未执行第一次搜索。这提示除了后续导航变化,生成风格本身也有所改变。
平均模型步数由 6.01 降至 5.56,但配对区间跨零;搜索数(1.298 → 1.258)与不同商品数(1.160 → 1.095)的配对差值也没有明确偏离零。因此不能把整体变化确定地概括为“搜索更少”或“步数更少”。
| 指标 | Base | Iter80 | 差值 | 95% 区间 |
|---|---|---|---|---|
| 模型步 | 6.008 | 5.555 | -0.453 | [-1.083, +0.160] |
| token / 步 | 282.388 | 159.455 | -122.933 | [-142.190, -104.312] |
| token / episode | 1704.928 | 1021.500 | -683.428 | [-898.903, -466.375] |
| 搜索 | 1.298 | 1.258 | -0.040 | [-0.160, +0.080] |
| 不同商品 | 1.160 | 1.095 | -0.065 | [-0.138, +0.003] |
| 翻页 | 0.245 | 0.018 | -0.228 | [-0.367, -0.110] |
| 无效动作 | 0.403 | 0.087 | -0.315 | [-0.500, -0.155] |
| 协议错误 | 0.147 | 0.347 | +0.200 | [+0.068, +0.347] |
Base 与 Iter80 均成功的 211 个任务提供了额外切片:每步生成下降 92.32 token,95% 区间 [−102.08, −83.79],而步数下降仍不确定。这个子集由两端 outcome 共同选择,只适合描述,不是无偏因果子组。所有区间使用 5,000 次任务配对 percentile bootstrap,描述本次训练条件下的任务变异;探索性指标未做多重比较校正。
环境动作更有效,协议解析问题却更多
固定验证集每 episode 的无效环境动作由 0.4025 降至 0.0875,而协议解析错误由 0.1475 升至 0.3475。前者问的是已提交动作在环境中是否合法,后者问的是模型输出能否解析为要求的工具调用,两种失败可以反向变化。
在两端均打开过商品的 399 个任务上,首次打开商品的结果排名从 4.96 降至 1.30;每任务翻页由 0.245 降至 0.0175。二者共同表明更倾向于靠前结果,但不能单独证明查询语义更好,也不能证明减少比较总是有益,仍需结合匹配质量和任务结果。
生成变化发生在哪些页面
按动作之前的页面将 turn 划为搜索首页、搜索结果、商品详情与协议修复,分别对应初始规划、结果选择、规格核验与格式修复。按 turn 加权的均值和 p90 可以揭示 episode 均值掩盖的长输出。
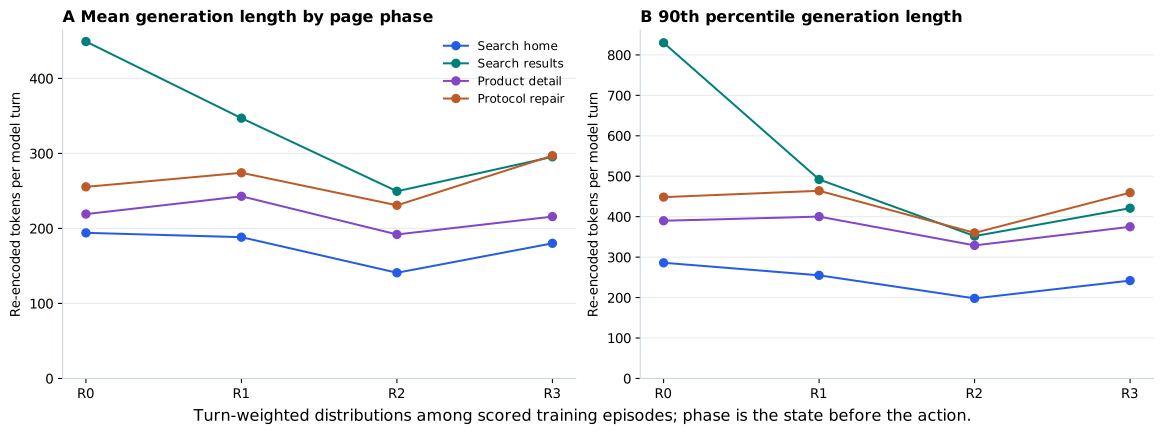
训练生成长度并不单调,每 episode 的平均每步 token 分别为 277.30、255.02、190.09、221.26。轮次边界上技能内容和训练任务都在变化,不能把曲线归因为纯参数变化,也不能直接与基于 API usage 的评测曲线共用绝对 token 标尺。
有明确选择规则的轨迹案例
下面是事后挑选的机制示例,不是随机样本,也不说明现象发生率。既包含改善,也包含退化。路径仅展示动作类别,不公开完整私有任务上下文;同分时选择较小 task ID。
Task 1828 · 两端均成功:步数下降最多
Base · 25 turns · 6,174 tokens · success=1
Iter80 · 4 turns · 740 tokens · success=1
Task 3538 · 失败 → 成功:token 降幅最大
Base · 30 turns · 13,465 tokens · success=0
Iter80 · 4 turns · 1,045 tokens · success=1
Task 4359 · 成功 → 失败:最终轨迹最长
Base · 4 turns · 959 tokens · success=1
Iter80 · 30 turns · 6,084 tokens · success=0
下载与扩展
训练 episode 表、训练 turn 表、评测 episode、评测 turn 可用于进一步切片。汇总 JSON 包含全部 80 步、均值/中位数/p90、成功失败分布、各轮 skill-free/assisted 汇总、页面阶段统计及配对元数据。
训练内辅助条件比较是观察性的,受 q、任务分配、筛选和技能内容影响,不能当作加上最终 skill 的随机效果估计。测试结果与 W&B 诊断补充了这些行为测量。